66 %
Le dernier dixième est plus chargé en action
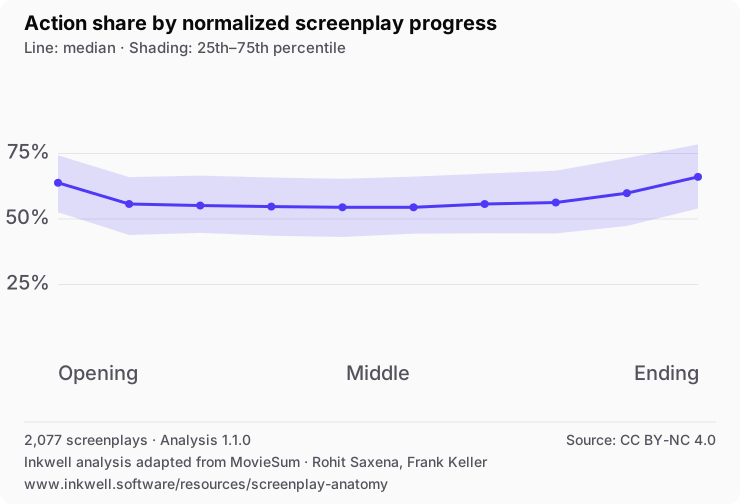
La médiane passe de 54 % d’action vers le milieu à 66 % à la fin. Le dialogue est le complément.
Atlas d’anatomie du scénario · août 2026
Nous avons normalisé 2 077 scénarios structurés de la première scène à la dernière, puis mesuré ce qui change : l’équilibre entre action et dialogue, le rythme des scènes, l’arrivée des personnages qui parlent et qui porte le dialogue. Ce sont des tendances d’un corpus, pas des consignes sur l’endroit où votre histoire doit basculer.
Que contient-il vraiment ? Parmi les fichiers retenus figurent Alien, Chinatown, Fargo, Inception, Moonlight, Parasite et Whiplash, ainsi que plus de 2 000 autres scénarios. Ce sont des versions archivées, qui ne disent rien du montage final ni du scénario de tournage.
D’abord, trois constats
Chaque chiffre clé ci-dessous est repris plus loin dans l’atlas avec sa distribution. Aucun ne définit un scénario « correct » ni ne sépare les films produits des projets non produits.
La médiane passe de 54 % d’action vers le milieu à 66 % à la fin. Le dialogue est le complément.
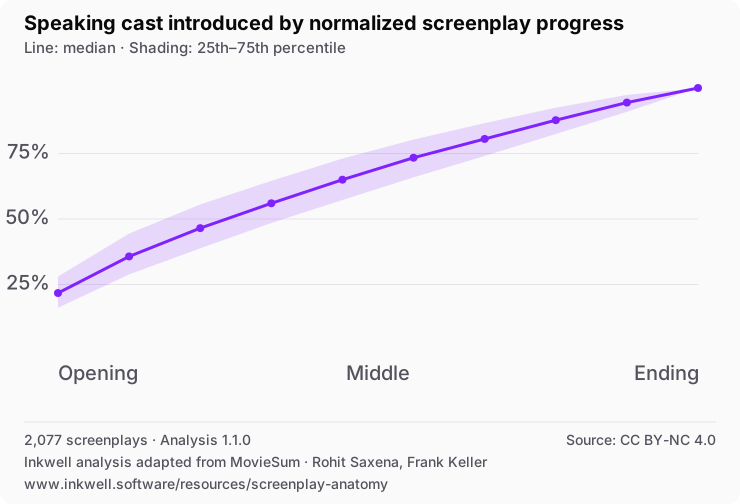
Seuls 22 % des personnages qui finiront par parler apparaissent dans le premier dixième ; à mi-parcours, la médiane atteint 65 %.
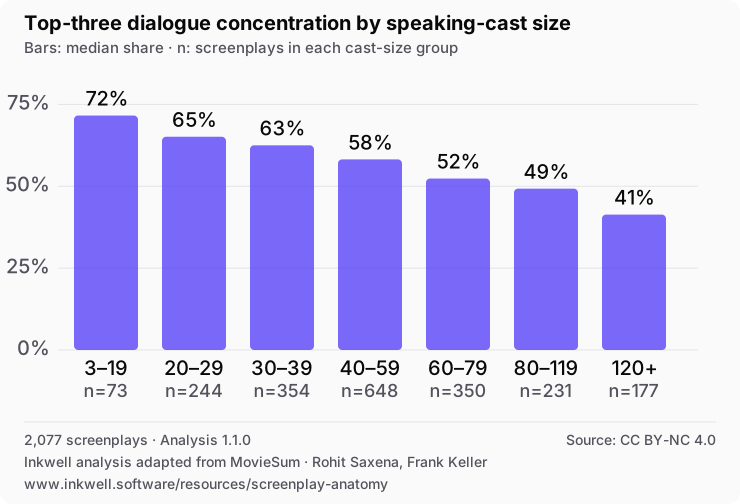
À mesure que le nombre de personnages qui parlent augmente, les trois voix les plus présentes portent en général une part plus faible du dialogue. Le score −0,523 mesure la régularité avec laquelle ces deux grandeurs évoluent en sens inverse ; ce n’est pas une note de qualité.
Évolution au fil du scénario
Imaginez chaque scénario comme dix tronçons égaux de texte narratif. L’action représente en médiane 63,8 % du premier tronçon, se stabilise autour de 54,5 % vers le milieu et atteint 66,1 % dans le dernier. La zone ombrée reste large : beaucoup de scénarios s’écartent nettement de cette courbe.
Nous découpons chaque scénario en dix tronçons égaux de texte narratif. La ligne est le scénario médian ; la bande ombrée contient la moitié centrale.
Ligne : médiane · Zone ombrée : 25ᵉ au 75ᵉ centile
Choisissez une tranche, ou touchez ou survolez le graphique, pour voir les valeurs exactes.
| Avancée | 25ᵉ centile | Médiane | 75ᵉ centile |
|---|---|---|---|
| 0–10 % | 52,6 % | 63,8 % | 74,3 % |
| 10–20 % | 43,9 % | 55,7 % | 66,0 % |
| 20–30 % | 44,7 % | 55,1 % | 66,6 % |
| 30–40 % | 43,6 % | 54,7 % | 65,8 % |
| 40–50 % | 43,1 % | 54,5 % | 65,4 % |
| 50–60 % | 44,4 % | 54,5 % | 66,2 % |
| 60–70 % | 44,6 % | 55,7 % | 67,3 % |
| 70–80 % | 44,5 % | 56,3 % | 68,5 % |
| 80–90 % | 47,4 % | 59,9 % | 73,3 % |
| 90–100 % | 54,0 % | 66,1 % | 78,5 % |
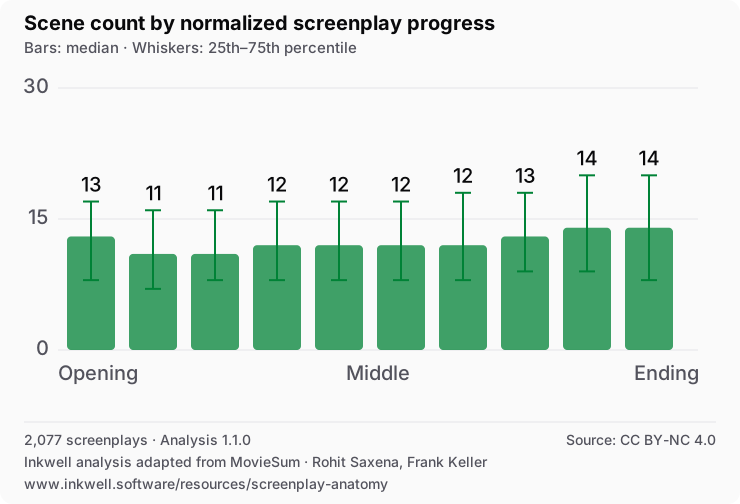
Chaque barre compte le nombre de scènes contenues dans une même quantité de texte narratif. Une barre plus haute signifie des scènes plus courtes en moyenne – pas une section plus longue.
Barres : médiane · Moustaches : 25ᵉ au 75ᵉ centile
Choisissez une tranche, ou touchez ou survolez le graphique, pour voir les valeurs exactes.
| Avancée | 25ᵉ centile | Médiane | 75ᵉ centile |
|---|---|---|---|
| 0–10 % | 8 | 13 | 17 |
| 10–20 % | 7 | 11 | 16 |
| 20–30 % | 8 | 11 | 16 |
| 30–40 % | 8 | 12 | 17 |
| 40–50 % | 8 | 12 | 17 |
| 50–60 % | 8 | 12 | 17 |
| 60–70 % | 8 | 12 | 18 |
| 70–80 % | 9 | 13 | 18 |
| 80–90 % | 9 | 14 | 20 |
| 90–100 % | 8 | 14 | 20 |
Le nombre de scènes donne un second signal. Chaque tronçon contient la même part de mots narratifs, et pourtant la fin médiane compte 14 scènes contre 12 vers le milieu. Dans cette représentation, la fin se compose de scènes plus nombreuses et plus courtes. Cela ne prouve pas un rythme plus rapide à l’écran ou au montage, qui demande le film terminé.
Arrivée des personnages
Découpez un scénario en dix tronçons égaux de texte narratif. Dans le scénario médian, seuls 21,7 % de tous ceux qui finiront par parler sont apparus après le premier tronçon. La part atteint 65,0 % à mi-parcours et 94,4 % à la fin du neuvième.
Les seconds rôles et les rôles d’une seule réplique comptent : cela ne veut pas dire que les protagonistes arrivent tard. Cela veut dire qu’une règle générale comme « présentez toute la distribution d’emblée » ne décrit pas ce que font réellement ces scénarios.
À chaque dixième, quelle part de tous ceux qui finiront par parler est déjà apparue ? Les rôles d’une seule réplique comptent aussi.
Ligne : médiane · Zone ombrée : 25ᵉ au 75ᵉ centile
Choisissez une tranche, ou touchez ou survolez le graphique, pour voir les valeurs exactes.
| Avancée | 25ᵉ centile | Médiane | 75ᵉ centile |
|---|---|---|---|
| 0–10 % | 16,1 % | 21,7 % | 28,1 % |
| 10–20 % | 28,9 % | 35,7 % | 44,4 % |
| 20–30 % | 38,8 % | 46,5 % | 55,6 % |
| 30–40 % | 48,5 % | 56,0 % | 64,6 % |
| 40–50 % | 57,3 % | 65,0 % | 73,1 % |
| 50–60 % | 65,9 % | 73,4 % | 80,3 % |
| 60–70 % | 74,1 % | 80,6 % | 86,6 % |
| 70–80 % | 82,5 % | 87,7 % | 92,5 % |
| 80–90 % | 90,9 % | 94,4 % | 97,4 % |
| 90–100 % | 100,0 % | 100,0 % | 100,0 % |
Le centre de gravité du dialogue
Dans le scénario médian, les trois personnages les plus bavards prononcent 57,2 % de tout le dialogue. Dans les scénarios de moins de 20 personnages qui parlent, ils en portent environ 72 % ; à partir de 120, la part tombe à environ 41 %.
La vraie question n’est pas de savoir si une grande distribution est « une erreur », mais si le lecteur sait encore quels choix font avancer la scène. Le score de rang sous-jacent vaut −0,523 ; il décrit une tendance, pas l’efficacité dramatique.
Dans chaque groupe de taille de distribution, quelle part de tout le dialogue revient aux trois personnages les plus bavards ?
Barres : part médiane · n : scénarios par taille de distribution
Choisissez une tranche, ou touchez ou survolez le graphique, pour voir les valeurs exactes.
| Personnages qui parlent | Scénarios | Part médiane des trois premiers |
|---|---|---|
| 3–19 | 73 | 71,6 % |
| 20–29 | 244 | 65,1 % |
| 30–39 | 354 | 62,5 % |
| 40–59 | 648 | 58,2 % |
| 60–79 | 350 | 52,4 % |
| 80–119 | 231 | 49,3 % |
| 120 et plus | 177 | 41,4 % |
Anatomie du corpus
Le repère central est la médiane : la moitié des scénarios retenus se situe au-dessus, l’autre moitié en dessous. La barre large contient la moitié centrale des scénarios. Ce sont des nombres de mots et de scènes, pas de pages, car MovieSum ne conserve pas une pagination fiable.
Mots narratifs
Scènes
Longueur typique d’une scène (mots)
Personnages qui parlent
Récit contenu dans les 10 % de scènes les plus longues
Scènes sans dialogue
Les deux dernières mesures viennent directement du contenu des scènes. Dans le scénario médian, le dixième des scènes les plus longues porte 38 % de tous les mots d’action et de dialogue, tandis que 29 % des scènes ne contiennent aucun dialogue balisé. Elles révèlent la concentration et le silence – pas l’efficacité de ces choix.
Ce qu’un résumé laisse de côté
Le résumé médian ne garde que 3,02 % des mots comptés du scénario. Cette réduction efface le jeu, la mise en scène, le rythme et l’essentiel des causes et des effets à l’intérieur des scènes. Les chiffres ci-dessous aident à comprendre ce que les résumés écartent ; ils ne doivent pas servir à juger le savoir-faire d’un scénario.
Pour l’échelle : le scénario médian contient 20 759 mots narratifs et son résumé 656. Les scénarios plus longs ne reçoivent pas systématiquement des résumés proportionnellement plus longs.
Expressions uniques du résumé absentes du scénario
« Absente » signifie que la suite exacte de mots n’apparaît pas dans le scénario. Il peut s’agir d’une paraphrase utile ou d’une erreur ; ce test ne sait pas les distinguer. La leçon est plus simple : les résumés décrivent souvent les événements avec des mots que le scénario lui-même n’emploie jamais.
Méthode et limites
Nous avons gardé les scénarios assez fournis pour une comparaison fiable : au moins 20 scènes, 5 000 mots d’action et de dialogue, trois personnages qui parlent et 20 blocs de dialogue.
Chaque scénario devient dix tronçons égaux de texte narratif, de la première scène à la dernière. Chaque scénario compte pour une voix, si bien qu’un scénario très long ne peut pas écraser les autres.
Ce n’est pas un échantillon de tous les scénarios en cours d’écriture. La position dans le texte n’est ni un numéro de page ni une durée à l’écran, et une tendance fréquente n’est pas forcément un bon choix.
Les graphiques utilisent des médianes et des quartiles observés plutôt que de supposer une courbe en cloche. Les données téléchargeables comprennent aussi des intervalles bootstrap déterministes à 95 %, des corrélations de rang et des contrôles d’ajustement log-normal.
Nous avons examiné 2 200 fiches, retenu 2 077 et exclu 123. Les motifs d’exclusion peuvent se recouper lorsqu’un fichier manque plus d’un seuil.
La version d’analyse 1.1.0 consigne les seuils, la graine aléatoire et l’empreinte de la source dans le JSON agrégé. Aucun texte de scénario, résumé, identifiant IMDb ni mesure par titre n’est diffusé.
Travaillez avec les mesures
Ouvrez un tableau dans un tableur, comparez ses quantiles ou construisez une autre vue des mêmes mesures. Le JSON complet conserve les corrélations, les diagnostics d’ajustement et la méthode à côté de ces tableaux. Les fichiers sont en anglais.
Part de l’action, scènes par dixième normalisé et arrivée cumulée des personnages qui parlent, avec quantiles empiriques et intervalles publiés de la médiane.
30 lignes de mesures · Analyse 1.1.0
2 077 scénarios admissibles. Le nombre de scénarios par tranche de distribution figure à côté de chaque mesure ; le nombre d’observations finies de chaque statistique n’est pas publié.
| Mesure | P10 | P25 | Médiane | P75 | P90 | Borne basse de l’intervalle | Borne haute de l’intervalle |
|---|---|---|---|---|---|---|---|
| Part des mots d’actionfraction · 0–10 % | 0,4186 | 0,5257 | 0,6382 | 0,743 | 0,8262 | 0,6318 | 0,6486 |
| Scènes par dixième normaliséscènes · 0–10 % | 5 | 8 | 13 | 17 | 23 | 12 | 13 |
| Personnages qui parlent introduitsfraction · 0–10 % | 0,1247 | 0,1613 | 0,2174 | 0,2807 | 0,3571 | 0,2121 | 0,2211 |
| Part des mots d’actionfraction · 10–20 % | 0,3419 | 0,439 | 0,5573 | 0,6598 | 0,755 | 0,5501 | 0,566 |
| Scènes par dixième normaliséscènes · 10–20 % | 5 | 7 | 11 | 16 | 21 | 11 | 11 |
| Personnages qui parlent introduitsfraction · 10–20 % | 0,2338 | 0,2885 | 0,3571 | 0,4444 | 0,5202 | 0,3511 | 0,3636 |
| Part des mots d’actionfraction · 20–30 % | 0,3339 | 0,4471 | 0,5514 | 0,6657 | 0,7656 | 0,5434 | 0,5607 |
| Scènes par dixième normaliséscènes · 20–30 % | 5 | 8 | 11 | 16 | 22 | 11 | 12 |
| Personnages qui parlent introduitsfraction · 20–30 % | 0,3333 | 0,3881 | 0,4651 | 0,5556 | 0,6414 | 0,4603 | 0,4727 |
| Part des mots d’actionfraction · 30–40 % | 0,3418 | 0,4361 | 0,5474 | 0,6584 | 0,7612 | 0,5389 | 0,5569 |
| Scènes par dixième normaliséscènes · 30–40 % | 5 | 8 | 12 | 17 | 23 | 11 | 12 |
| Personnages qui parlent introduitsfraction · 30–40 % | 0,4245 | 0,4848 | 0,56 | 0,6458 | 0,7253 | 0,5541 | 0,5667 |
| Part des mots d’actionfraction · 40–50 % | 0,3345 | 0,4314 | 0,5447 | 0,6535 | 0,7569 | 0,5351 | 0,5535 |
| Scènes par dixième normaliséscènes · 40–50 % | 5 | 8 | 12 | 17 | 22,4 | 11 | 12 |
| Personnages qui parlent introduitsfraction · 40–50 % | 0,5152 | 0,5726 | 0,65 | 0,7308 | 0,8046 | 0,6429 | 0,6552 |
| Part des mots d’actionfraction · 50–60 % | 0,3396 | 0,444 | 0,5446 | 0,6617 | 0,7669 | 0,5375 | 0,5529 |
| Scènes par dixième normaliséscènes · 50–60 % | 5 | 8 | 12 | 17 | 23 | 12 | 12 |
| Personnages qui parlent introduitsfraction · 50–60 % | 0,6026 | 0,6591 | 0,7339 | 0,8033 | 0,8681 | 0,7292 | 0,7407 |
| Part des mots d’actionfraction · 60–70 % | 0,3411 | 0,4455 | 0,5572 | 0,6734 | 0,7703 | 0,5506 | 0,5654 |
| Scènes par dixième normaliséscènes · 60–70 % | 5 | 8 | 12 | 18 | 24 | 12 | 13 |
| Personnages qui parlent introduitsfraction · 60–70 % | 0,68 | 0,7407 | 0,8056 | 0,8661 | 0,92 | 0,8 | 0,8107 |
| Part des mots d’actionfraction · 70–80 % | 0,3381 | 0,4449 | 0,5629 | 0,6845 | 0,7966 | 0,5522 | 0,5755 |
| Scènes par dixième normaliséscènes · 70–80 % | 5 | 9 | 13 | 18 | 25 | 12 | 13 |
| Personnages qui parlent introduitsfraction · 70–80 % | 0,7725 | 0,8246 | 0,8772 | 0,925 | 0,963 | 0,8718 | 0,881 |
| Part des mots d’actionfraction · 80–90 % | 0,3599 | 0,4735 | 0,5987 | 0,7327 | 0,8291 | 0,5879 | 0,6102 |
| Scènes par dixième normaliséscènes · 80–90 % | 5 | 9 | 14 | 20 | 27 | 13 | 14 |
| Personnages qui parlent introduitsfraction · 80–90 % | 0,8684 | 0,9091 | 0,9444 | 0,9737 | 1 | 0,9412 | 0,9467 |
| Part des mots d’actionfraction · 90–100 % | 0,4194 | 0,5402 | 0,6608 | 0,7848 | 0,8655 | 0,6481 | 0,6696 |
| Scènes par dixième normaliséscènes · 90–100 % | 5 | 8 | 14 | 20 | 28 | 13 | 14 |
| Personnages qui parlent introduitsfraction · 90–100 % | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
Longueur du scénario et du résumé, nombre de scènes et de personnages, concentration, compression et expressions nouvelles du résumé. Chaque ligne résume une mesure sur tout le corpus.
15 lignes de mesures · Analyse 1.1.0
2 077 scénarios admissibles. Le nombre de scénarios par tranche de distribution figure à côté de chaque mesure ; le nombre d’observations finies de chaque statistique n’est pas publié.
| Mesure | P10 | P25 | Médiane | P75 | P90 | Borne basse de l’intervalle | Borne haute de l’intervalle |
|---|---|---|---|---|---|---|---|
| Mots narratifsmots · Corpus entier | 15 871,6 | 18 380 | 21 579 | 25 179 | 29 019,4 | — | — |
| Mots narratifs segmentésmots · Corpus entier | 15 476,4 | 17 908 | 20 759 | 23 715 | 27 087,2 | — | — |
| Nombre de scènesscènes · Corpus entier | 68 | 97 | 130 | 168 | 211 | — | — |
| Longueur médiane d’une scènemots · Corpus entier | 52,5 | 70 | 94 | 132 | 189 | — | — |
| Dixième des scènes les plus longuesfraction · Corpus entier | 0,317 | 0,3455 | 0,3792 | 0,4199 | 0,4615 | — | — |
| Scènes sans dialoguefraction · Corpus entier | 0,1329 | 0,2027 | 0,2945 | 0,3852 | 0,4697 | — | — |
| Nombre de personnages qui parlentpersonnages · Corpus entier | 26 | 36 | 50 | 72 | 110 | — | — |
| Part des mots d’actionfraction · Corpus entier | 0,3957 | 0,4859 | 0,579 | 0,6751 | 0,7398 | — | — |
| Part du dialogue des trois premiersfraction · Corpus entier | 0,3979 | 0,4798 | 0,5718 | 0,6603 | 0,7354 | — | — |
| Couverture des en-têtes de scènefraction · Corpus entier | 0,9863 | 0,9913 | 0,9947 | 1 | 1 | — | — |
| Mots du résumémots · Corpus entier | 410,6 | 538 | 656 | 714 | 801,4 | — | — |
| Taux de compression du résuméfraction · Corpus entier | 0,019 | 0,025 | 0,0302 | 0,0366 | 0,0443 | — | — |
| Mots nouveaux du résuméfraction · Corpus entier | 0,242 | 0,2718 | 0,3056 | 0,3426 | 0,3784 | — | — |
| Expressions nouvelles de deux mots dans le résuméfraction · Corpus entier | 0,6727 | 0,6993 | 0,726 | 0,7557 | 0,7824 | — | — |
| Expressions nouvelles de trois mots dans le résuméfraction · Corpus entier | 0,9236 | 0,9378 | 0,9511 | 0,9627 | 0,9717 | — | — |
Nombre de personnages qui parlent et part du dialogue des trois voix les plus présentes dans chaque tranche de distribution publiée, avec son nombre de scénarios.
14 lignes de mesures · Analyse 1.1.0
2 077 scénarios admissibles. Le nombre de scénarios par tranche de distribution figure à côté de chaque mesure ; le nombre d’observations finies de chaque statistique n’est pas publié.
| Mesure | P10 | P25 | Médiane | P75 | P90 | Borne basse de l’intervalle | Borne haute de l’intervalle |
|---|---|---|---|---|---|---|---|
| Nombre de personnages qui parlentpersonnages · 3–1973 scénarios dans cette tranche | 9,2 | 13 | 15 | 17 | 19 | — | — |
| Part du dialogue des trois premiersfraction · 3–1973 scénarios dans cette tranche | 0,5947 | 0,6555 | 0,7159 | 0,8308 | 0,9197 | — | — |
| Nombre de personnages qui parlentpersonnages · 20–29244 scénarios dans cette tranche | 21 | 23 | 26 | 27 | 29 | — | — |
| Part du dialogue des trois premiersfraction · 20–29244 scénarios dans cette tranche | 0,5107 | 0,5771 | 0,6511 | 0,7365 | 0,7982 | — | — |
| Nombre de personnages qui parlentpersonnages · 30–39354 scénarios dans cette tranche | 31 | 33 | 35 | 37 | 38,7 | — | — |
| Part du dialogue des trois premiersfraction · 30–39354 scénarios dans cette tranche | 0,482 | 0,5346 | 0,625 | 0,6986 | 0,7554 | — | — |
| Nombre de personnages qui parlentpersonnages · 40–59648 scénarios dans cette tranche | 41 | 44,75 | 49 | 54 | 57 | — | — |
| Part du dialogue des trois premiersfraction · 40–59648 scénarios dans cette tranche | 0,4277 | 0,5023 | 0,582 | 0,6579 | 0,7178 | — | — |
| Nombre de personnages qui parlentpersonnages · 60–79350 scénarios dans cette tranche | 61 | 63 | 69 | 73 | 77 | — | — |
| Part du dialogue des trois premiersfraction · 60–79350 scénarios dans cette tranche | 0,3988 | 0,4567 | 0,5236 | 0,6016 | 0,6759 | — | — |
| Nombre de personnages qui parlentpersonnages · 80–119231 scénarios dans cette tranche | 81 | 86 | 95 | 104 | 113 | — | — |
| Part du dialogue des trois premiersfraction · 80–119231 scénarios dans cette tranche | 0,3543 | 0,4099 | 0,4927 | 0,5664 | 0,6284 | — | — |
| Nombre de personnages qui parlentpersonnages · 120 et plus177 scénarios dans cette tranche | 125 | 136 | 164 | 235 | 312,4 | — | — |
| Part du dialogue des trois premiersfraction · 120 et plus177 scénarios dans cette tranche | 0,2671 | 0,3427 | 0,4135 | 0,4914 | 0,5769 | — | — |
Pour une analyse en local, enregistrez un CSV et son dictionnaire dans le même dossier, en gardant les deux noms de fichier. Les métadonnées complètes décrivent les trois CSV ensemble.
Les parts sont des fractions de 0 à 1 ; multipliez-les par 100 pour obtenir un pourcentage.
P25–P75 décrit la variation entre scénarios. L’intervalle à 95 % estime l’incertitude d’une médiane ; ce n’est pas une plage contenant 95 % des scénarios. Une cellule d’intervalle vide signifie qu’aucun intervalle n’a été publié, pas une valeur nulle.
Les scénarios du corpus comptent les scénarios admissibles, pas le nombre d’observations finies derrière chaque statistique. Les scénarios du groupe ne sont publiés que pour les tranches de distribution ; l’agrégat source ne contient pas de nombre d’observations par dixième.
Mesurez le scénario que vous avez vraiment
Placez un projet sur ces mêmes distributions avec la carte de rythme – ou utilisez l’analyseur de scénario pour la forme des scènes, des personnages, des décors et du dialogue d’un projet, ou comparez deux versions sans réduire le scénario à une comparaison de texte générique.