66%
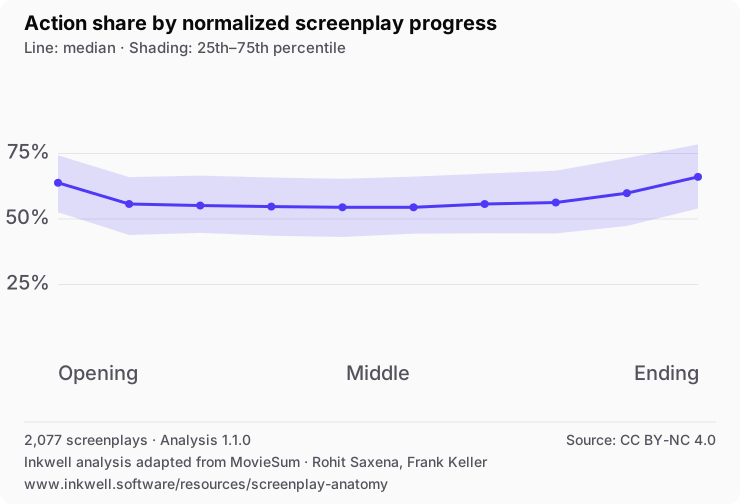
마지막 십분의 일은 액션이 더 많습니다
중앙값은 중간 지점 부근의 액션 54%에서 결말의 66%까지 올라갑니다. 나머지는 대사입니다.
시나리오 해부 아틀라스 · 2026년 8월
구조화된 시나리오 2,077편을 첫 장면부터 마지막 장면까지 정규화한 뒤 무엇이 달라지는지 측정했습니다. 액션과 대사의 균형, 장면의 리듬, 대사가 있는 인물이 등장하는 시점, 그리고 누가 대사를 이끄는지입니다. 이것은 코퍼스에서 나타나는 패턴이지, 이야기가 어디서 꺾여야 한다는 지침이 아닙니다.
실제로 무엇이 들어 있을까요? 포함된 파일에는 Alien, Chinatown, Fargo, Inception, Moonlight, Parasite, Whiplash 등 2,000편이 넘는 시나리오가 들어 있습니다. 모두 보관된 시나리오 판본이며, 최종 편집본이나 촬영 대본에 대해 말하는 것이 아닙니다.
먼저 세 가지 발견
아래의 핵심 수치는 모두 아틀라스 뒷부분에서 분포와 나란히 제시합니다. 어떤 수치도 ‘올바른’ 시나리오를 정하지 않으며, 제작된 영화와 제작되지 않은 원고를 가르지도 않습니다.
중앙값은 중간 지점 부근의 액션 54%에서 결말의 66%까지 올라갑니다. 나머지는 대사입니다.
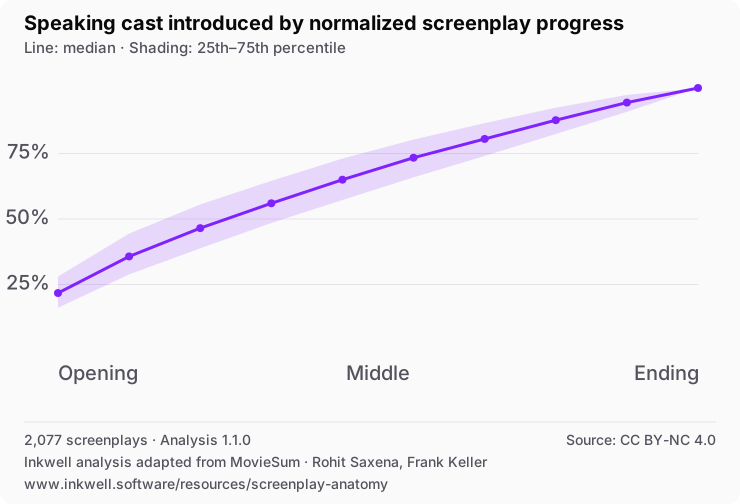
결국 대사를 하게 될 인물 가운데 첫 십분의 일에 등장하는 비율은 22%에 불과하고, 절반 지점에서 중앙값은 65%에 이릅니다.
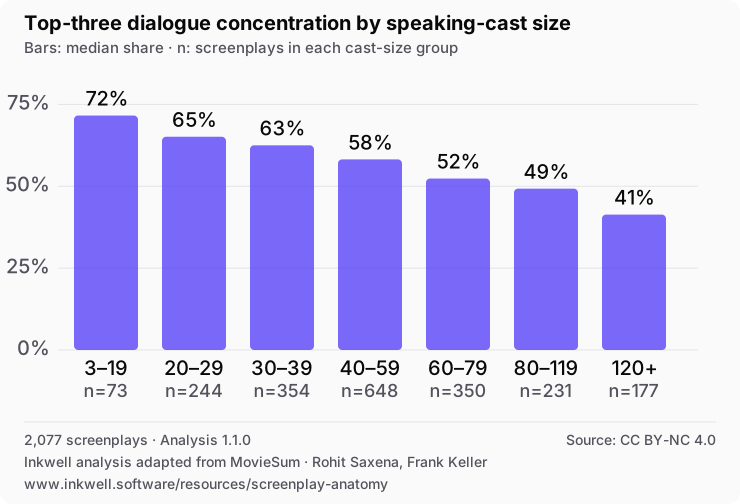
대사가 있는 인물이 늘어날수록 가장 말이 많은 세 인물이 차지하는 대사 비중은 대체로 줄어듭니다. −0.523 값은 두 수치가 얼마나 꾸준히 반대 방향으로 움직이는지를 나타내며, 품질 점수가 아닙니다.
원고 전체의 흐름
각 시나리오를 서술 텍스트 기준으로 똑같은 열 구간으로 나눴다고 생각해 보세요. 액션 비중의 중앙값은 첫 구간에서 63.8%, 중반에는 54.5% 안팎으로 자리 잡고, 마지막 구간에서 66.1%에 이릅니다. 음영 범위는 여전히 넓어서, 이 굴곡에서 크게 벗어나는 시나리오도 많습니다.
모든 시나리오를 서술 텍스트 기준으로 똑같은 열 구간으로 나눕니다. 선은 중앙의 시나리오이고, 음영 띠에는 가운데 절반이 들어갑니다.
선: 중앙값 · 음영: 25~75번째 백분위수
구간을 고르거나 그래프를 탭하거나 위에 올려 정확한 값을 확인하세요.
| 진행 | 25번째 백분위수 | 중앙값 | 75번째 백분위수 |
|---|---|---|---|
| 0~10% | 52.6% | 63.8% | 74.3% |
| 10~20% | 43.9% | 55.7% | 66.0% |
| 20~30% | 44.7% | 55.1% | 66.6% |
| 30~40% | 43.6% | 54.7% | 65.8% |
| 40~50% | 43.1% | 54.5% | 65.4% |
| 50~60% | 44.4% | 54.5% | 66.2% |
| 60~70% | 44.6% | 55.7% | 67.3% |
| 70~80% | 44.5% | 56.3% | 68.5% |
| 80~90% | 47.4% | 59.9% | 73.3% |
| 90~100% | 54.0% | 66.1% | 78.5% |
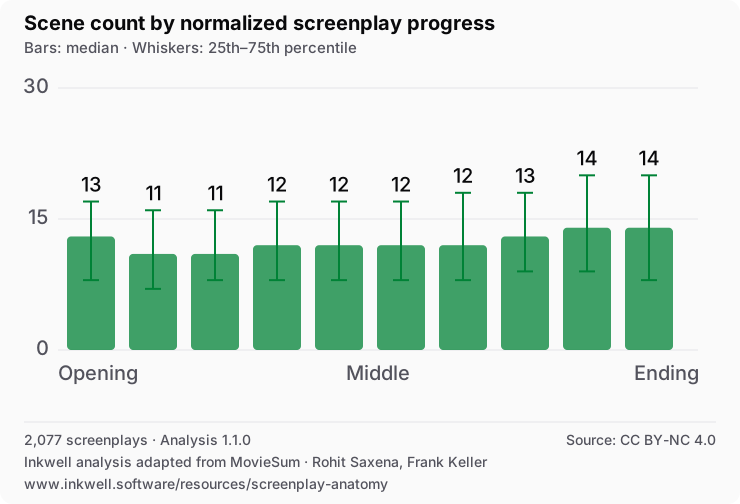
각 막대는 같은 양의 서술 텍스트에 들어가는 장면 수를 셉니다. 막대가 높을수록 장면이 평균적으로 짧다는 뜻이지, 구간이 길다는 뜻이 아닙니다.
막대: 중앙값 · 수염: 25~75번째 백분위수
구간을 고르거나 그래프를 탭하거나 위에 올려 정확한 값을 확인하세요.
| 진행 | 25번째 백분위수 | 중앙값 | 75번째 백분위수 |
|---|---|---|---|
| 0~10% | 8 | 13 | 17 |
| 10~20% | 7 | 11 | 16 |
| 20~30% | 8 | 11 | 16 |
| 30~40% | 8 | 12 | 17 |
| 40~50% | 8 | 12 | 17 |
| 50~60% | 8 | 12 | 17 |
| 60~70% | 8 | 12 | 18 |
| 70~80% | 9 | 13 | 18 |
| 80~90% | 9 | 14 | 20 |
| 90~100% | 8 | 14 | 20 |
장면 수가 두 번째 신호를 줍니다. 모든 구간에 서술 단어가 같은 비율로 들어 있는데도, 결말의 중앙값은 14개 장면이고 중간 지점 부근은 12개입니다. 이 방식으로 보면 결말은 더 많고 더 짧은 장면으로 이루어집니다. 다만 화면 속 시간이나 편집 템포가 더 빠르다는 것까지 입증하지는 못합니다. 그러려면 완성된 영화가 필요합니다.
인물의 등장
시나리오를 서술 텍스트 기준으로 똑같은 열 구간으로 나눕니다. 중앙의 시나리오에서는 첫 구간이 끝났을 때 결국 대사를 하게 될 인물 가운데 21.7%만 등장해 있습니다. 이 비율은 절반 지점에서 65.0%, 아홉 번째 구간이 끝날 때 94.4%가 됩니다.
조연과 대사 한 줄짜리 역할도 셈에 넣었으므로, 주인공이 늦게 등장한다는 뜻은 아닙니다. ‘인물은 처음에 모두 소개하라’는 일률적인 규칙이 이 시나리오들이 실제로 하는 일을 설명하지 못한다는 뜻입니다.
십분의 일마다, 결국 대사를 하게 될 인물 가운데 얼마가 등장했을까요? 대사 한 줄짜리 역할도 셉니다.
선: 중앙값 · 음영: 25~75번째 백분위수
구간을 고르거나 그래프를 탭하거나 위에 올려 정확한 값을 확인하세요.
| 진행 | 25번째 백분위수 | 중앙값 | 75번째 백분위수 |
|---|---|---|---|
| 0~10% | 16.1% | 21.7% | 28.1% |
| 10~20% | 28.9% | 35.7% | 44.4% |
| 20~30% | 38.8% | 46.5% | 55.6% |
| 30~40% | 48.5% | 56.0% | 64.6% |
| 40~50% | 57.3% | 65.0% | 73.1% |
| 50~60% | 65.9% | 73.4% | 80.3% |
| 60~70% | 74.1% | 80.6% | 86.6% |
| 70~80% | 82.5% | 87.7% | 92.5% |
| 80~90% | 90.9% | 94.4% | 97.4% |
| 90~100% | 100.0% | 100.0% | 100.0% |
대사의 무게중심
중앙의 시나리오에서는 가장 말이 많은 세 인물이 전체 대사의 57.2%를 맡습니다. 대사가 있는 인물이 20명 미만인 시나리오에서는 약 72%이고, 120명 이상인 시나리오에서는 약 41%로 내려갑니다.
실제로 따져 볼 질문은 인물이 많은 것이 ‘잘못’인지가 아닙니다. 읽는 사람이 여전히 누구의 선택이 장면을 움직이는지 알아볼 수 있는지입니다. 바탕이 되는 순위 값은 −0.523이며, 패턴을 나타낼 뿐 극적 효과를 뜻하지 않습니다.
인물 수 그룹마다, 가장 말이 많은 세 인물이 전체 대사에서 차지하는 비중은 얼마일까요?
막대: 비중의 중앙값 · n: 인물 수 그룹별 시나리오 수
구간을 고르거나 그래프를 탭하거나 위에 올려 정확한 값을 확인하세요.
| 대사가 있는 인물 | 시나리오 수 | 상위 세 인물 비중의 중앙값 |
|---|---|---|
| 3~19 | 73 | 71.6% |
| 20~29 | 244 | 65.1% |
| 30~39 | 354 | 62.5% |
| 40~59 | 648 | 58.2% |
| 60~79 | 350 | 52.4% |
| 80~119 | 231 | 49.3% |
| 120 이상 | 177 | 41.4% |
코퍼스 해부
가운데 표시가 중앙값으로, 포함된 시나리오의 절반은 그보다 위에, 절반은 아래에 있습니다. 넓은 막대에는 가운데 절반의 시나리오가 들어갑니다. MovieSum은 안정적인 쪽 나눔을 보존하지 않으므로, 쪽수가 아니라 단어 수와 장면 수로 셉니다.
서술 단어 수
장면 수
일반적인 장면 길이(단어)
대사가 있는 인물
가장 긴 10% 장면에 담긴 이야기
대사가 없는 장면
마지막 두 지표는 장면 내용에서 바로 구했습니다. 중앙의 시나리오에서는 가장 긴 십분의 일 장면이 액션과 대사 단어의 38%를 차지하고, 장면의 29%에는 표시된 대사가 없습니다. 이는 집중과 침묵을 보여 줄 뿐, 그 선택이 효과가 있는지는 말해 주지 않습니다.
줄거리 요약이 남기지 못하는 것
중앙의 요약에는 시나리오에서 센 단어의 3.02%만 남습니다. 이렇게 줄이면서 연기, 연출, 리듬, 그리고 장면 안의 인과 관계 대부분이 사라집니다. 아래 수치는 요약이 무엇을 버리는지 설명하는 데 도움이 될 뿐, 시나리오의 기량을 평가하는 데 쓰면 안 됩니다.
규모를 가늠해 보면, 중앙의 시나리오에는 서술 단어가 20,759개 있고 그 요약에는 656개가 있습니다. 긴 시나리오라고 해서 그만큼 긴 요약이 붙는 것은 아닙니다.
시나리오에 없는 요약 고유의 표현
‘없다’는 정확히 그 단어 순서가 시나리오에 나오지 않는다는 뜻입니다. 유용한 바꿔 말하기일 수도, 오류일 수도 있으며, 이 검사로는 구별하지 못합니다. 얻을 수 있는 교훈은 더 단순합니다. 요약은 시나리오 자체가 한 번도 쓰지 않는 말로 사건을 설명하는 경우가 많습니다.
방법과 한계
믿을 만하게 비교할 수 있을 만큼 분량이 있는 시나리오만 남겼습니다. 장면 20개 이상, 액션과 대사 단어 5,000개 이상, 대사가 있는 인물 세 명 이상, 대사 블록 20개 이상입니다.
모든 시나리오를 첫 장면부터 마지막 장면까지 서술 텍스트 기준으로 똑같은 열 구간으로 나눕니다. 시나리오마다 한 표씩이므로 아주 긴 시나리오 하나가 나머지를 압도할 수 없습니다.
현재 쓰이고 있는 모든 시나리오의 표본이 아닙니다. 단어 위치는 쪽수도 상영 시간도 아니며, 흔한 패턴이 저절로 좋은 선택이 되지도 않습니다.
그래프는 종 모양 분포를 가정하지 않고 중앙값과 관측된 사분위수를 씁니다. 내려받을 수 있는 데이터에는 결정론적 95% 부트스트랩 구간, 순위 상관, 로그정규 적합 점검도 들어 있습니다.
레코드 2,200건을 확인해 2,077건을 포함하고 123건을 제외했습니다. 한 파일이 둘 이상의 기준에 못 미치면 제외 건수가 겹칠 수 있습니다.
분석 버전 1.1.0은 기준값, 난수 시드, 원본 데이터 지문을 집계 JSON에 기록합니다. 시나리오 본문, 요약, IMDb 식별자, 작품별 측정값은 제공하지 않습니다.
측정값 활용하기
스프레드시트에서 표를 열어 분위수를 비교하거나, 같은 측정값으로 다른 보기를 만들어 보세요. 전체 JSON에는 이 표들과 함께 상관관계, 적합 진단, 방법론이 들어 있습니다. 파일은 영어입니다.
액션 비중, 정규화한 십분의 일별 장면 수, 대사가 있는 인물의 누적 등장을 경험적 분위수 및 공개된 중앙값 구간과 함께 보여 줍니다.
측정값 30행 · 분석 1.1.0
대상 시나리오 2,077편. 인물 수 그룹별 편수는 각 지표 옆에 표시했으며, 개별 통계량의 유효 관측 수는 공개하지 않습니다.
| 지표 | P10 | P25 | 중앙값 | P75 | P90 | 중앙값 구간 하한 | 중앙값 구간 상한 |
|---|---|---|---|---|---|---|---|
| 액션 단어 비중비중 · 0~10% | 0.4186 | 0.5257 | 0.6382 | 0.743 | 0.8262 | 0.6318 | 0.6486 |
| 정규화한 십분의 일별 장면 수장면 · 0~10% | 5 | 8 | 13 | 17 | 23 | 12 | 13 |
| 등장한 대사가 있는 인물비중 · 0~10% | 0.1247 | 0.1613 | 0.2174 | 0.2807 | 0.3571 | 0.2121 | 0.2211 |
| 액션 단어 비중비중 · 10~20% | 0.3419 | 0.439 | 0.5573 | 0.6598 | 0.755 | 0.5501 | 0.566 |
| 정규화한 십분의 일별 장면 수장면 · 10~20% | 5 | 7 | 11 | 16 | 21 | 11 | 11 |
| 등장한 대사가 있는 인물비중 · 10~20% | 0.2338 | 0.2885 | 0.3571 | 0.4444 | 0.5202 | 0.3511 | 0.3636 |
| 액션 단어 비중비중 · 20~30% | 0.3339 | 0.4471 | 0.5514 | 0.6657 | 0.7656 | 0.5434 | 0.5607 |
| 정규화한 십분의 일별 장면 수장면 · 20~30% | 5 | 8 | 11 | 16 | 22 | 11 | 12 |
| 등장한 대사가 있는 인물비중 · 20~30% | 0.3333 | 0.3881 | 0.4651 | 0.5556 | 0.6414 | 0.4603 | 0.4727 |
| 액션 단어 비중비중 · 30~40% | 0.3418 | 0.4361 | 0.5474 | 0.6584 | 0.7612 | 0.5389 | 0.5569 |
| 정규화한 십분의 일별 장면 수장면 · 30~40% | 5 | 8 | 12 | 17 | 23 | 11 | 12 |
| 등장한 대사가 있는 인물비중 · 30~40% | 0.4245 | 0.4848 | 0.56 | 0.6458 | 0.7253 | 0.5541 | 0.5667 |
| 액션 단어 비중비중 · 40~50% | 0.3345 | 0.4314 | 0.5447 | 0.6535 | 0.7569 | 0.5351 | 0.5535 |
| 정규화한 십분의 일별 장면 수장면 · 40~50% | 5 | 8 | 12 | 17 | 22.4 | 11 | 12 |
| 등장한 대사가 있는 인물비중 · 40~50% | 0.5152 | 0.5726 | 0.65 | 0.7308 | 0.8046 | 0.6429 | 0.6552 |
| 액션 단어 비중비중 · 50~60% | 0.3396 | 0.444 | 0.5446 | 0.6617 | 0.7669 | 0.5375 | 0.5529 |
| 정규화한 십분의 일별 장면 수장면 · 50~60% | 5 | 8 | 12 | 17 | 23 | 12 | 12 |
| 등장한 대사가 있는 인물비중 · 50~60% | 0.6026 | 0.6591 | 0.7339 | 0.8033 | 0.8681 | 0.7292 | 0.7407 |
| 액션 단어 비중비중 · 60~70% | 0.3411 | 0.4455 | 0.5572 | 0.6734 | 0.7703 | 0.5506 | 0.5654 |
| 정규화한 십분의 일별 장면 수장면 · 60~70% | 5 | 8 | 12 | 18 | 24 | 12 | 13 |
| 등장한 대사가 있는 인물비중 · 60~70% | 0.68 | 0.7407 | 0.8056 | 0.8661 | 0.92 | 0.8 | 0.8107 |
| 액션 단어 비중비중 · 70~80% | 0.3381 | 0.4449 | 0.5629 | 0.6845 | 0.7966 | 0.5522 | 0.5755 |
| 정규화한 십분의 일별 장면 수장면 · 70~80% | 5 | 9 | 13 | 18 | 25 | 12 | 13 |
| 등장한 대사가 있는 인물비중 · 70~80% | 0.7725 | 0.8246 | 0.8772 | 0.925 | 0.963 | 0.8718 | 0.881 |
| 액션 단어 비중비중 · 80~90% | 0.3599 | 0.4735 | 0.5987 | 0.7327 | 0.8291 | 0.5879 | 0.6102 |
| 정규화한 십분의 일별 장면 수장면 · 80~90% | 5 | 9 | 14 | 20 | 27 | 13 | 14 |
| 등장한 대사가 있는 인물비중 · 80~90% | 0.8684 | 0.9091 | 0.9444 | 0.9737 | 1 | 0.9412 | 0.9467 |
| 액션 단어 비중비중 · 90~100% | 0.4194 | 0.5402 | 0.6608 | 0.7848 | 0.8655 | 0.6481 | 0.6696 |
| 정규화한 십분의 일별 장면 수장면 · 90~100% | 5 | 8 | 14 | 20 | 28 | 13 | 14 |
| 등장한 대사가 있는 인물비중 · 90~100% | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
시나리오와 요약의 길이, 장면 수와 인물 수, 집중도, 압축률, 요약에 새로 나타나는 표현입니다. 각 행이 코퍼스 전체에서 지표 하나를 요약합니다.
측정값 15행 · 분석 1.1.0
대상 시나리오 2,077편. 인물 수 그룹별 편수는 각 지표 옆에 표시했으며, 개별 통계량의 유효 관측 수는 공개하지 않습니다.
| 지표 | P10 | P25 | 중앙값 | P75 | P90 | 중앙값 구간 하한 | 중앙값 구간 상한 |
|---|---|---|---|---|---|---|---|
| 서술 단어 수단어 · 코퍼스 전체 | 15,871.6 | 18,380 | 21,579 | 25,179 | 29,019.4 | — | — |
| 토큰화한 서술 단어 수단어 · 코퍼스 전체 | 15,476.4 | 17,908 | 20,759 | 23,715 | 27,087.2 | — | — |
| 장면 수장면 · 코퍼스 전체 | 68 | 97 | 130 | 168 | 211 | — | — |
| 장면 길이의 중앙값단어 · 코퍼스 전체 | 52.5 | 70 | 94 | 132 | 189 | — | — |
| 가장 긴 십분의 일 장면비중 · 코퍼스 전체 | 0.317 | 0.3455 | 0.3792 | 0.4199 | 0.4615 | — | — |
| 대사가 없는 장면비중 · 코퍼스 전체 | 0.1329 | 0.2027 | 0.2945 | 0.3852 | 0.4697 | — | — |
| 대사가 있는 인물 수인물 · 코퍼스 전체 | 26 | 36 | 50 | 72 | 110 | — | — |
| 액션 단어 비중비중 · 코퍼스 전체 | 0.3957 | 0.4859 | 0.579 | 0.6751 | 0.7398 | — | — |
| 상위 세 인물의 대사 비중비중 · 코퍼스 전체 | 0.3979 | 0.4798 | 0.5718 | 0.6603 | 0.7354 | — | — |
| 씬 헤딩 표기율비중 · 코퍼스 전체 | 0.9863 | 0.9913 | 0.9947 | 1 | 1 | — | — |
| 요약 단어 수단어 · 코퍼스 전체 | 410.6 | 538 | 656 | 714 | 801.4 | — | — |
| 요약 압축률비중 · 코퍼스 전체 | 0.019 | 0.025 | 0.0302 | 0.0366 | 0.0443 | — | — |
| 요약에 새로 나타나는 단어비중 · 코퍼스 전체 | 0.242 | 0.2718 | 0.3056 | 0.3426 | 0.3784 | — | — |
| 요약에 새로 나타나는 두 단어 표현비중 · 코퍼스 전체 | 0.6727 | 0.6993 | 0.726 | 0.7557 | 0.7824 | — | — |
| 요약에 새로 나타나는 세 단어 표현비중 · 코퍼스 전체 | 0.9236 | 0.9378 | 0.9511 | 0.9627 | 0.9717 | — | — |
공개된 인물 수 그룹마다 대사가 있는 인물 수와 가장 말이 많은 세 인물의 대사 비중을 그 그룹의 시나리오 수와 함께 보여 줍니다.
측정값 14행 · 분석 1.1.0
대상 시나리오 2,077편. 인물 수 그룹별 편수는 각 지표 옆에 표시했으며, 개별 통계량의 유효 관측 수는 공개하지 않습니다.
| 지표 | P10 | P25 | 중앙값 | P75 | P90 | 중앙값 구간 하한 | 중앙값 구간 상한 |
|---|---|---|---|---|---|---|---|
| 대사가 있는 인물 수인물 · 3~19이 그룹의 시나리오 73편 | 9.2 | 13 | 15 | 17 | 19 | — | — |
| 상위 세 인물의 대사 비중비중 · 3~19이 그룹의 시나리오 73편 | 0.5947 | 0.6555 | 0.7159 | 0.8308 | 0.9197 | — | — |
| 대사가 있는 인물 수인물 · 20~29이 그룹의 시나리오 244편 | 21 | 23 | 26 | 27 | 29 | — | — |
| 상위 세 인물의 대사 비중비중 · 20~29이 그룹의 시나리오 244편 | 0.5107 | 0.5771 | 0.6511 | 0.7365 | 0.7982 | — | — |
| 대사가 있는 인물 수인물 · 30~39이 그룹의 시나리오 354편 | 31 | 33 | 35 | 37 | 38.7 | — | — |
| 상위 세 인물의 대사 비중비중 · 30~39이 그룹의 시나리오 354편 | 0.482 | 0.5346 | 0.625 | 0.6986 | 0.7554 | — | — |
| 대사가 있는 인물 수인물 · 40~59이 그룹의 시나리오 648편 | 41 | 44.75 | 49 | 54 | 57 | — | — |
| 상위 세 인물의 대사 비중비중 · 40~59이 그룹의 시나리오 648편 | 0.4277 | 0.5023 | 0.582 | 0.6579 | 0.7178 | — | — |
| 대사가 있는 인물 수인물 · 60~79이 그룹의 시나리오 350편 | 61 | 63 | 69 | 73 | 77 | — | — |
| 상위 세 인물의 대사 비중비중 · 60~79이 그룹의 시나리오 350편 | 0.3988 | 0.4567 | 0.5236 | 0.6016 | 0.6759 | — | — |
| 대사가 있는 인물 수인물 · 80~119이 그룹의 시나리오 231편 | 81 | 86 | 95 | 104 | 113 | — | — |
| 상위 세 인물의 대사 비중비중 · 80~119이 그룹의 시나리오 231편 | 0.3543 | 0.4099 | 0.4927 | 0.5664 | 0.6284 | — | — |
| 대사가 있는 인물 수인물 · 120 이상이 그룹의 시나리오 177편 | 125 | 136 | 164 | 235 | 312.4 | — | — |
| 상위 세 인물의 대사 비중비중 · 120 이상이 그룹의 시나리오 177편 | 0.2671 | 0.3427 | 0.4135 | 0.4914 | 0.5769 | — | — |
직접 분석하려면 CSV와 그 표 사전을 같은 폴더에 저장하고 두 파일 이름을 모두 그대로 두세요. 전체 표 메타데이터는 세 CSV를 함께 설명합니다.
비중은 0에서 1 사이의 소수입니다. 백분율로 나타내려면 100을 곱하세요.
P25~P75는 시나리오 사이의 편차를 나타냅니다. 95% 구간은 중앙값의 불확실성을 추정한 것으로, 시나리오의 95%가 들어가는 범위가 아닙니다. 구간 칸이 비어 있으면 구간을 공개하지 않았다는 뜻이지 0이라는 뜻이 아닙니다.
코퍼스 시나리오 수는 대상 시나리오의 편수이며, 각 통계량에 쓰인 유효 관측 수가 아닙니다. 그룹 시나리오 수는 인물 수 그룹에 대해서만 공개합니다. 십분의 일별 관측 수는 원본 집계에 없습니다.
지금 가진 원고를 재 보세요
호흡 지도로 원고 하나를 바로 이 분포 위에 올려 보거나, 시나리오 분석기로 원고 하나의 장면, 인물, 장소, 대사의 형태를 살펴보거나, 시나리오를 일반 텍스트 비교로 뭉개지 않고 두 고쳐 쓴 판을 비교해 보세요.