시나리오 대사는 대개 페이지 단위로 이야기됩니다. 긴 독백, 빽빽한 장면, 회색 대화 두 줄기처럼 보이는 페이지. 그런데 그 밑에 있는 단위는 훨씬 작습니다.
대사 한 번은 시나리오가 다른 요소로 넘어가기 전까지 한 인물 이름 아래에서 이어지는 말 한 덩어리입니다. 조건을 충족하는 분석된 시나리오 994편에서, 각 시나리오의 대사 길이 중앙값들의 중앙값은 일곱 단어입니다. 이와 별도로, 각 시나리오의 대사 길이 90번째 백분위수의 중앙값은 스물네 단어입니다.
이것은 말뭉치를 두 가지로 요약한 것이지, 상상 속 ‘중앙값 시나리오’ 한 편을 두 번 잰 것이 아닙니다. 둘을 함께 보면 같은 큰 모양이 드러납니다. 시나리오 속 대화는 짧은 대사 여러 개와, 그보다 적은 긴 대사의 꼬리로 이루어져 있습니다.
일곱 단어는 기준점이지 규칙이 아닙니다이 섹션 링크
말뭉치의 중앙값은 경험적 근거가 있는 처방처럼 보여서 끌립니다. 하지만 처방이 아닙니다.
고백에 예순 단어가 필요하다면 일곱 단어로 줄이는 순간 장면이 무너집니다. 농담이 두 단어로 먹힌다면 일곱 단어로 늘리는 것도 똑같이 우스운 일입니다. 이 측정이 알려 주는 것은 이 말뭉치에서 시나리오 대사가 이루는 모양이지, 대사 한 줄의 올바른 길이가 아닙니다.
쓸모 있는 관찰은 대비입니다. 짧은 대사는 하나의 리듬을 만들고, 끊기지 않는 긴 대사는 그 리듬을 바꿉니다. 고쳐 쓸 때 물어야 할 것은 “이 대사가 일곱 단어를 넘는가?”가 아니라 “이 인물이 계속 말을 이어 가면 장면에 무슨 일이 생기는가?”입니다.
긴 대사는 단어 수보다 많은 것을 바꿉니다이 섹션 링크
긴 대사는 여러 가지를 한꺼번에 바꿉니다.
첫째, 시각적 밀도를 바꿉니다. 긴 덩어리가 여러 개 있는 페이지는 새 인물 이름이나 지문의 여백으로 숨을 돌리기 전까지 읽는 사람을 한 목소리 안에 더 오래 머물게 합니다.
둘째, 대화의 주도권을 바꿉니다. 말하고 있는 인물은 대사가 끝나거나, 누군가 끼어들거나, 행동이 대화를 끊을 때까지 말의 시간을 쥐고 있습니다.
셋째, 대비를 바꿉니다. 짧은 대사들 사이의 긴 대사는 읽는 사람이 내용을 받아들이기도 전에 페이지 위에서 존재를 드러냅니다.
그래서 마흔 단어가 어떤 장면에서는 강렬하게, 다른 장면에서는 지치게 느껴질 수 있습니다. 절대적인 길이는 같아도 그 자리의 리듬은 다릅니다.
대사 횟수와 단어 수는 다른 질문에 답합니다이 섹션 링크
대사의 단어 수를 세면 한 인물이 얼마나 많은 말을 받는지 알 수 있습니다. 대사 횟수를 세면 대화가 그 인물에게 얼마나 자주 돌아오는지 알 수 있습니다.
둘은 크게 어긋날 수 있습니다. 어떤 인물은 길고 드문 덩어리로 말합니다. 다른 인물은 짧은 끼어들기를 끊임없이 해서 대화를 장악합니다. 단어 수는 비슷해도 대화 속 존재감은 전혀 다르게 느껴질 수 있습니다.
그래서 대사 균형 도구는 말하기의 집중도를 요약할 때 인물에게 귀속된 대사 횟수의 비중을 씁니다. 질문은 누가 단어 수 경쟁에서 이기느냐가 아니라, 대화가 각 목소리로 몇 번이나 돌아오느냐입니다.
고쳐 쓸 때는 이 구분이 쓸모 있습니다.
- 단어 수는 말의 양과 밀도를 나타냅니다.
- 대사 횟수는 주고받는 빈도와 말하는 부담이 어떻게 나뉘는지를 나타냅니다.
- 장면 구성은 대사가 있는 장면에 서로 다른 화자가 몇 명 참여하는지를 나타냅니다.
이 중 어느 측정도 대사가 좋은지는 알려 주지 않습니다.
두 사람이 말하는 장면이 고른 대화라는 뜻은 아닙니다이 섹션 링크
말뭉치는 장면 구성에 대한 맥락도 줍니다. 대사가 있는 장면의 화자 수는 시나리오별 중앙값으로 보면 대개 두 명입니다. 시나리오마다 같은 무게를 주면, 대사가 있는 장면 가운데 평균 37% 안팎이 두 사람이 말하는 장면이고, 나머지는 한 사람 장면과 세 사람 이상 장면으로 나뉩니다.
하지만 ‘두 화자’는 전혀 다른 구조를 가리킬 수 있습니다. 고른 주고받기, 심문, 세 번 끊기는 독백, 또는 말을 꺼내려다 번번이 실패하는 누군가.
그래서 장면을 점검할 때는 배역 목록보다 한 단계 더 내려가야 합니다. 누가 대사를 쥐고 있는지, 주도권이 얼마나 자주 바뀌는지, 행동이 대화에 마디를 넣는지 물으세요.
직접 점검한다면 이렇게 물어볼 수 있습니다.
- 대화를 시작하는 사람은 누구인가?
- 가장 길게 끊기지 않고 말하는 사람은 누구인가?
- 대화가 각 화자에게 얼마나 자주 돌아오는가?
- 행동이 말의 리듬을 끊는 곳은 어디인가?
- 누군가가 원하는 것이나 아는 것을 실제로 바꾸는 대사는 무엇인가?
처음 네 가지는 관찰할 수 있습니다. 다섯 번째는 여전히 작가가 필요합니다.
지표가 제값을 할 때이 섹션 링크
대사 길이는 읽은 사람의 메모가 막연할 때 가장 쓸모 있습니다. 말이 너무 많다, 설명이 너무 많다, 장면이 멈춰 있다, 다들 연설하는 것 같다.
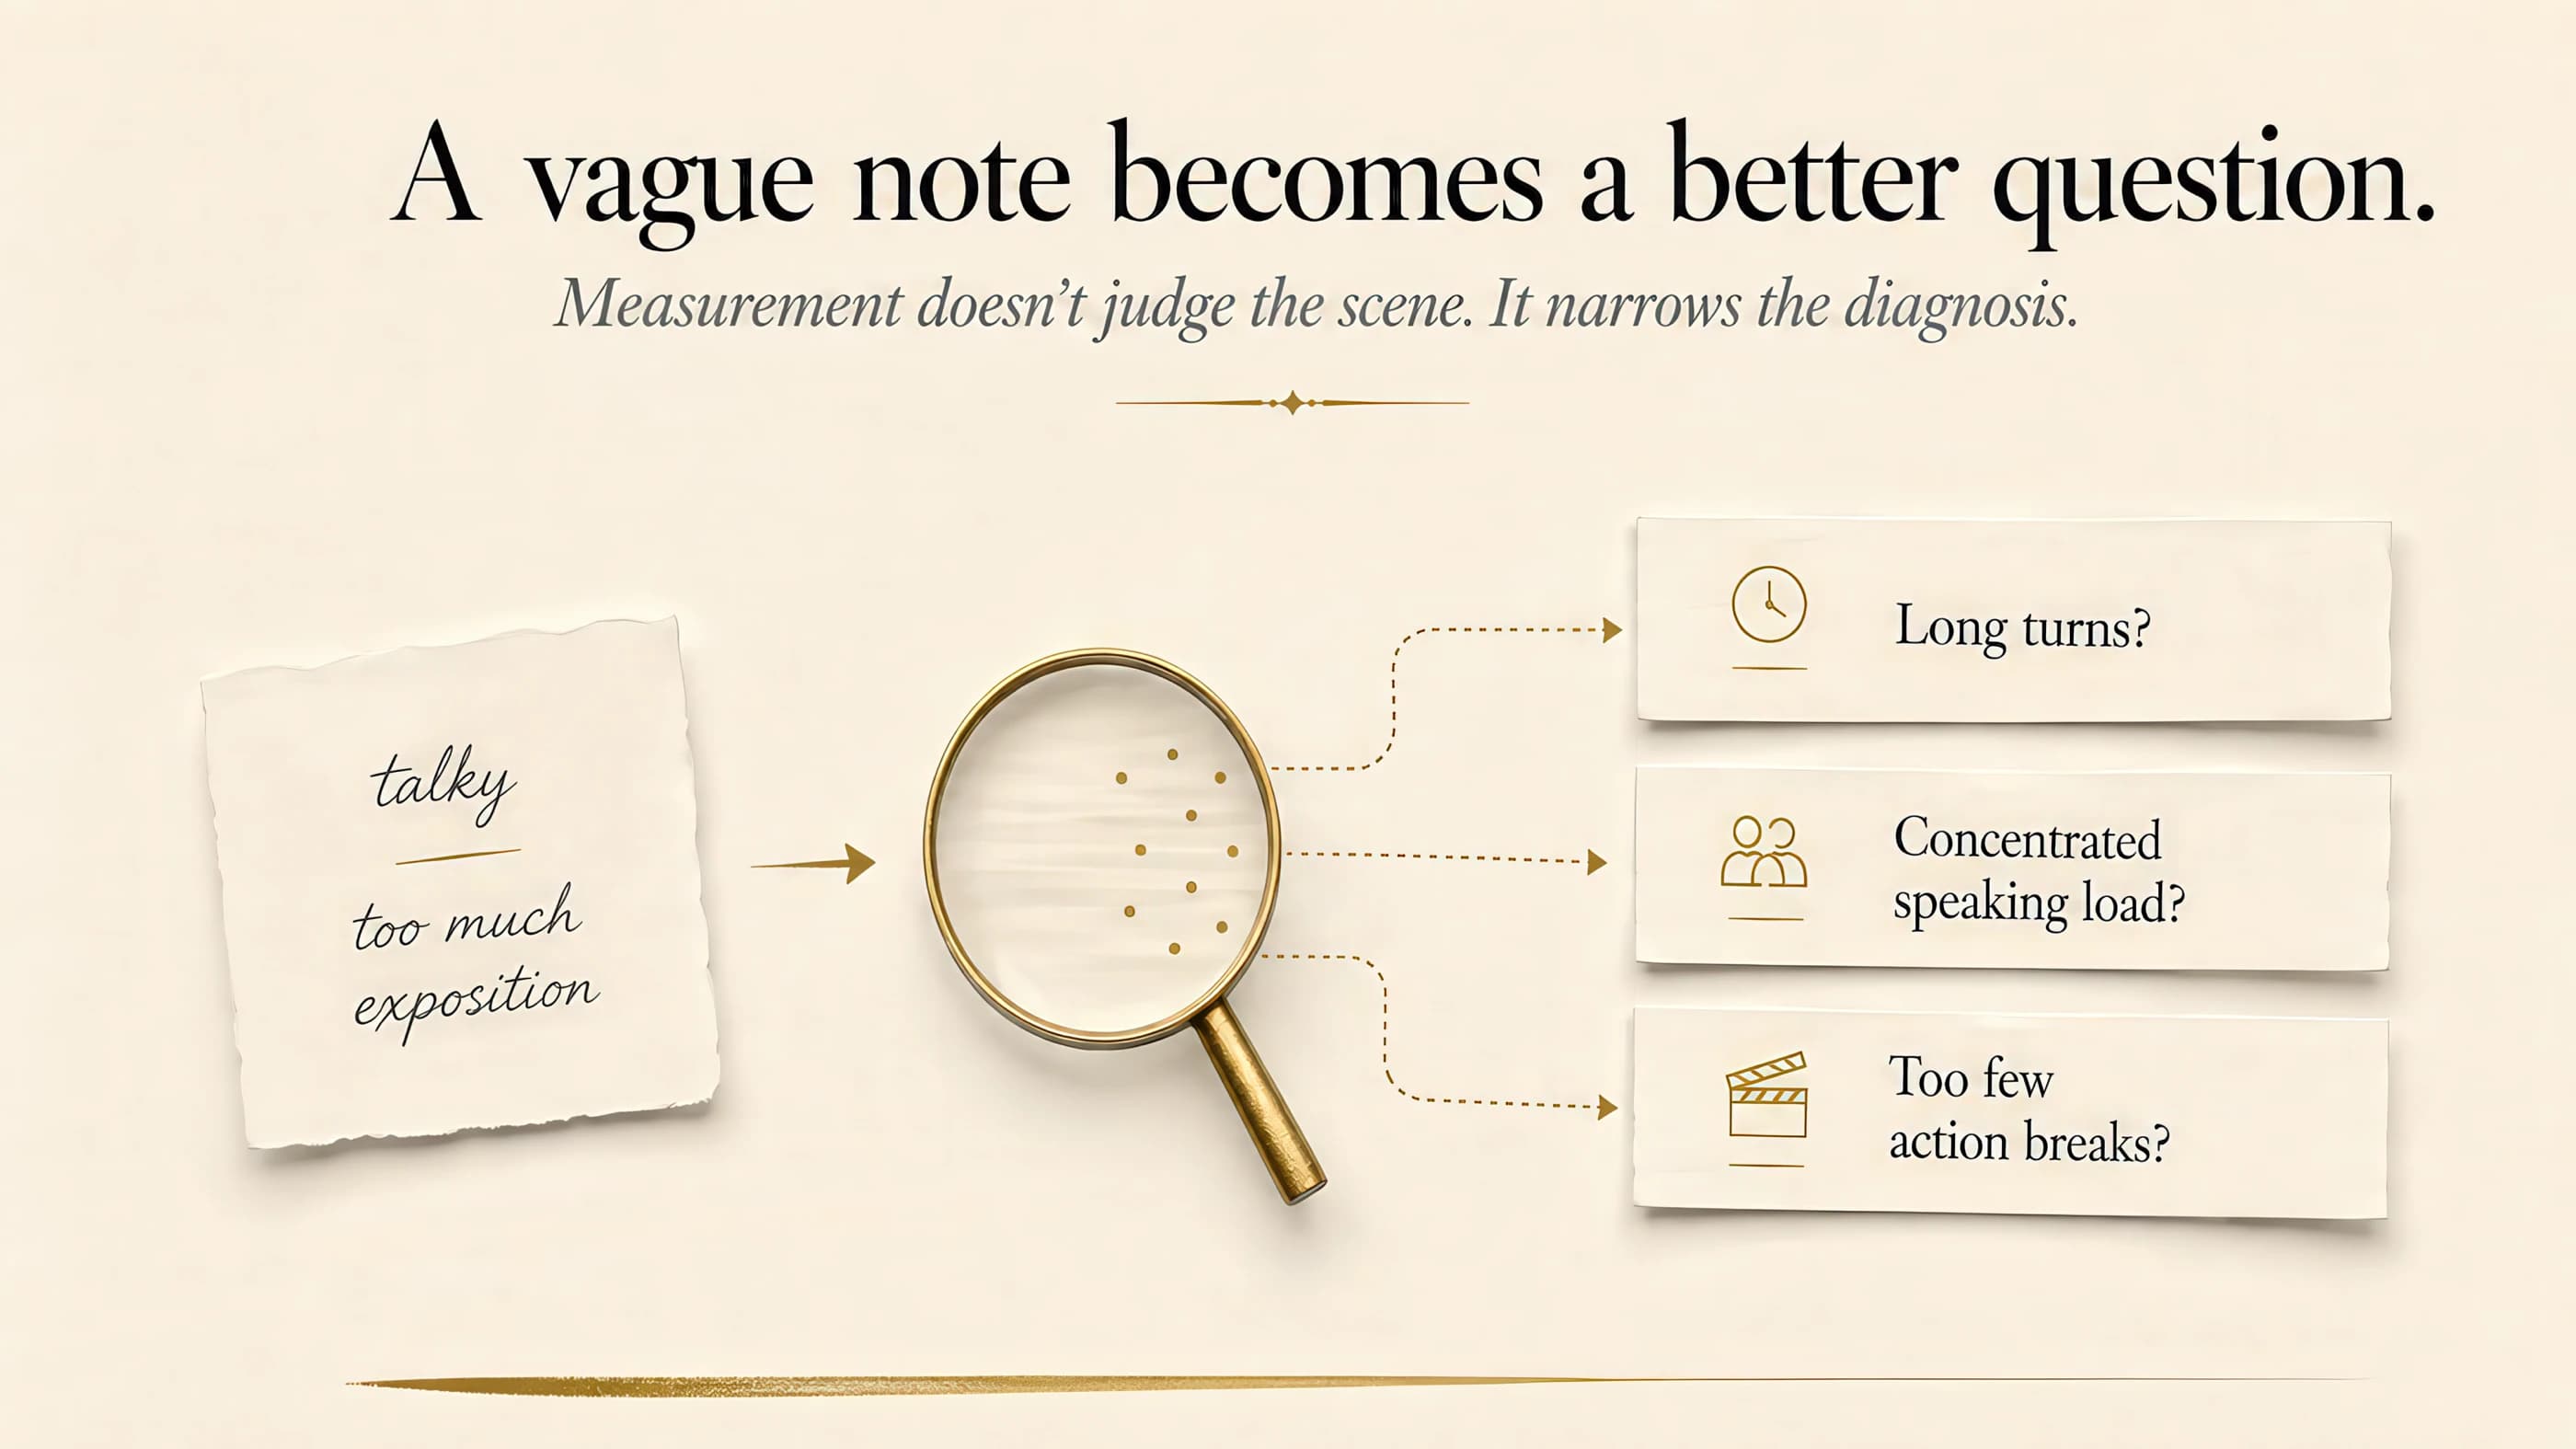
숫자로 이런 메모를 증명할 수는 없습니다. 측정이 할 수 있는 일은 가능한 원인을 여러 갈래로 나누는 것입니다. 대사 길이는 평범한데 말하는 부담이 유난히 한쪽에 몰린 초안이 있을 수 있습니다. 두 사람 장면의 비율은 흔한 수준인데 한 인물이 거의 모든 대사를 가져가는 경우도 있습니다. 아니면 문제가 대사의 양과 전혀 상관없을 수도 있습니다.
시나리오 대사 리서치는 이런 비교의 바탕이 되는 기준 분포를 공개합니다. 대사 균형 도구는 말하기의 집중도와 장면 구성을 보여 주지만, 긴 대사가 있는 개별 장면을 찾아 주는 기능은 현재 없습니다. 그러니 줄 단위의 리듬은 여전히 페이지를 직접 읽고 판단해야 합니다.
이 한계를 분명히 해 두는 것이 도움이 됩니다. 말뭉치 데이터의 목적은 판단을 자동화하는 것이 아닙니다. “뭔가 다르게 느껴진다”를 더 구체적인 질문으로 바꾼 다음, 결정을 작가에게 돌려주는 것입니다.